情報提供:
FlashLabs株式会社(本社:東京都千代田区、代表取締役:細井洋一、以下「FlashLabs」)は、米国のAI研究機関Continuum AIが開発し、当社が日本市場向けに独占提供するAI推論ゲートウェイ「OrcaRouter」(AIモデルへのアクセスを1つにまとめる中継サービス)において、ローカルGPU上で動くAIモデルを、ポート開放や複雑なネットワーク設定なしでセキュアな共有AI APIとして公開できる新機能「Orca Connect」(オルカ・コネクト)の提供を開始したことをお知らせします※1。
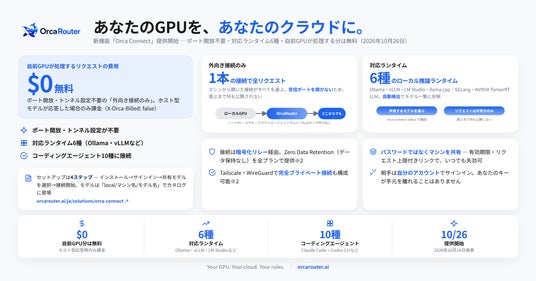
Orca Connectは、Ollama、vLLM、LM Studioなど、自分のマシン上で動くローカル推論ランタイムを、OrcaRouterのカタログに「local/マシン名/モデル名」として追加できるコネクタです※1。コネクタはマシンから外向きに1本の接続を開くだけで、ルーターやファイアウォールの受信ポートを開ける必要はありません※1。追加したモデルは、いつものAPIキーを使ってノートPCやスマートフォン、クラウド上のエージェントから呼び出せます※1。機能の詳細はOrca Connectのページを、セットアップ手順は公式ドキュメントをご参照ください。
主なポイント
- 自前GPUが処理する分は無料(ホスト型モデルが応答した場合のみ課金)※1※2
- ポート開放・トンネル設定・ファイアウォール変更が不要な「外向き接続のみ」の設計※1
- 対応ランタイムは6種(Ollama・vLLM・LM Studio・llama.cpp・SGLang・NVIDIA TensorRT-LLM)※1
- コーディングエージェント10種(Claude Code・Codex CLI・OpenCode・Gemini CLIなど)にワンコマンドで接続※1
- チーム共有は有効期限・リクエスト上限付きの共有リンクで、キーを渡さずに共有※1
- 暗号化リレーとZero Data Retention(全プラン対応)※2
開発の背景
AIモデルの活用が広がる一方で、ローカル環境でモデルを動かすケース(データを外部に出したくない、コストを抑えたい、オープンウェイトモデルを試したい、など)と、クラウド上のAPIモデルを使うケースの間には「接続の壁」がありました。ローカルで動くモデルを外部のアプリケーションやチームメンバーと共有するには、ポート開放やトンネルの設定、NAT越えといったネットワークの知識が必要で、セキュリティ上の不安も伴います※1。
Orca Connectは、この「接続の壁」を取り除くために開発されました。ローカルで動くモデルを、いつものOrcaRouterのAPIキー・エンドポイントで呼び出せるようにすることで、ローカルとクラウドのモデルを同じインターフェースで扱えるようにします※1。
Orca Connectの仕組み
Orca Connectは、自分のマシンにインストールして使うコネクタです。セットアップは次の4ステップです※1。
- インストール:管理画面(BYOK→Connectors)からOS向けのインストールコマンドを取得します。インストーラーは署名済みリリースを検証します※1
- サインイン:orca-connect loginでマシンを承認します。ブラウザでの承認のほか、画面のないサーバーではコードによる承認にも対応します※1
- 共有するモデルを選択:orca-connect statusでマシン上のランタイムとモデルを確認し、共有するモデルを選びます※1
- 接続開始:orca-connect serveで接続を開始します。モデルはカタログに「local/マシン名/モデル名」として表示されます※1
コネクタはマシンから外向きに1本の接続を開くだけで、すべてのリクエストを個別のストリームとして運びます※1。受信ポートを開かないため、共有するモデルを選ぶまでは何も公開されません※1。
課金の透明性
ローカルのマシンが処理したレスポンスには X-Orca-Billed: false が付き、リクエストは$0として記録されます※1。自前のハードウェアが処理する分は無料で、ホスト型モデルが応答した場合のみ課金されます※1※2。
スピルオーバー(spillover)
Orca Connectは、ローカルのマシンが応答できないときに、あらかじめ指定したホスト型モデルが代わりに応答する「スピルオーバー」機能を備えています※1。
- デフォルトはオフです。有効にすると、許可した理由(マシンがオフライン・ビジー、プロンプトが長すぎる、ランタイムエラー、ツールが必要なリクエスト)のときだけ、指定したホスト型モデルが月間上限の範囲内で応答します※1
- スピルオーバーで応答した場合、レスポンスには X-Orca-Spillover-Reason と見積もり費用が付きます※1
- リバーススピルオーバーにも対応します。コードに「gpt-4o-mini」と書いたまま、マッピングしたローカルモデルが動いていれば自分のGPUが応答し、動いていなければ従来どおりホスト型モデルが応答します※1
チーム共有とセキュリティ
- パスワードではなくマシンを共有:共有するモデルへのリンクを、有効期限・リクエスト上限付きで作成でき、いつでも取り消せます。受け取った相手は自分のアカウントでサインインするため、キーが手元を離れることはありません※1
- ローカル専用キー:キーを「ローカル専用」に設定すると、そのリクエストはローカルのマシンだけで処理され、ホスト型モデルが処理することも、課金されることもありません※1
- 暗号化リレーとZero Data Retention:接続は暗号化リレーを経由し、Zero Data Retention(ゼロ・データ・リテンション=データ保持なし)が全プランで利用できます。プロンプトやレスポンスはデフォルトでは保存されません※2
- 完全プライベート接続:TailscaleやWireGuardを使ってリレーを迂回し、エンドツーエンドの完全プライベート接続を構成することもできます※2
コーディングエージェントとの連携
orca-connect claudeを実行すると、Claude Codeがそのセッションに限り自分のモデルで起動します※1。claudeをcodex、opencode、gemini、qwen、kimi、copilot、aider、goose、piに置き換えることで、Codex CLI、OpenCode、Gemini CLI、Qwen Code、Kimi Code、Copilot CLI、Aider、Goose、piでも同様に利用できます※1。エージェント自体の設定は変更されません※1。
今後の展望
OrcaRouterは、ローカルとクラウドの垣根をなくし、「どこでモデルが動くか」を利用者自身が選べる環境を提供してまいります。Orca Connectを通じて、データの主権とコスト管理の両方を重視する企業や開発者のニーズに、引き続き応えてまいります。
OrcaRouterについて
OrcaRouterは、米国のAI研究機関Continuum AIが開発し、FlashLabs株式会社が日本市場向けに独占提供するAI推論ゲートウェイ(AIモデルへのアクセスを1つにまとめる中継サービス)です。OpenAI互換のAPIを備え、Anthropic、OpenAI、Google Gemini、DeepSeek、Grok、Qwenなど200以上のLLM・生成AIモデルを単一のゲートウェイから利用できます。直近では、GPT-6.1 Sol、Claude Sonnet 5.5、Gemini 3.8 Flash、Grok 4.6、DeepSeek-V4.1-Flashなど、各社の最新モデルが公開後まもなくカタログに追加されています。OrcaRouterのAIモデル一覧からすべてのモデルを確認できます。
会社概要
FlashLabs株式会社
- 本社所在地:東京都千代田区一番町10番8号
- 代表取締役:細井洋一
- 設立:2023年7月
- 事業内容:AI応用研究所(Human-AI Hybridで営業・CXの自動化・自律化。OSS音声モデルChromaの開発元)
- URL:https://www.flashlabs.ai/
Continuum AI
- 「次の10年の知能システムを支える基盤インフラを開発する研究機関(米国)」
- OrcaRouterの開発・提供
- URL:https://www.continuum01.ai/
本件に関するお問い合わせ
FlashLabs株式会社 マーケティング部 小林光喜
E-mail:koki.kobayashi@myflashcloud.com
※1 Orca Connectの機能・仕様は、OrcaRouter公式サイトのOrca Connectのページおよび公式ドキュメントに基づきます(2026年10月27日時点・当社確認)。対応ランタイム・対応エージェント・仕様は今後変更される可能性があります。
※2 「暗号化リレー」「Zero Data Retention(全プラン対応)」「Tailscale・WireGuardによる完全プライベート接続」は、OrcaRouter公式Xアカウント(@OrcaRouter)の発表(2026年10月26日)に基づきます。
特集
最新ニュース
学ぶ・知る
見る・遊ぶ
食べる
暮らす・働く
みん経トピックス
プレスリリース
-
株式会社yutori 片石貴展が"新入社員 公開最終面接(オファー)"!鈴木おさむ×THE RAMPAGE 陣のTOK...
-
Ragate株式会社、オールインワン業務システム「MOCHIRO」に債務支払い機能「MOCHIRO DEBT」を追加
-
OrcaRouter、ローカルGPUをセキュアな共有AI APIに変える新機能「Orca Connect」の提供を開始
-
【Architecture MasterPrize 2026】「三田ガーデンヒルズ センターヒル」が“Residential Landscape”部門でW...
-
10/30(金)〜11/12(木)《東方Project 博麗神社秋祭り2026 -生誕30th突破&東方紅魔郷:New Classic 発売記念...